В чем ловушка «наивного» автоответчика: скрытая математика контекста и токенов
Универсальный ИИ-автоответчик на отзывы Wildberries и Ozon с двухконтурной фильтрацией Jev AI отвечает на обращения за 60 секунд, защищает рейтинг магазина 4.8+ и экономит до 38% бюджета на токенах нейросетей. При потоке в 10 000 отзывов и вопросов порог уверенности 90% отсекает 38% нерелевантных запросов (брак, задержка логистики FBO/FBS маркетплейсов, дефицит характеристик карточки), предотвращая галлюцинации и снижая себестоимость генерации до 0.05 ₽ за ответ. Вместо раздельных подписок на WB и Озон за 6 000–15 000 ₽, единый автоответчик в RAMSTAT доступен от 0 ₽ на тарифе Free без карты или от 490 ₽/мес.
Большинство селлеров и разработчиков при создании автоответчиков для маркетплейсов совершают фундаментальную архитектурную ошибку: они настраивают прямую отправку каждого входящего отзыва и вопроса в генеративную языковую модель (LLM). Схема кажется интуитивной: пришел отзыв от покупателя на WB или Ozon → подтягиваем данные карточки → просим нейросеть написать вежливый ответ.
Однако на реальном трафике маркетплейсов эта схема финансово не эффективна. Чтобы нейросеть ответила фактологически точно, ей необходимо скормить полный контекст:
- Системный промпт с правилами бренда и регламентом площадки: ~2 000 символов (~1 100 токенов в токенизаторах OpenAI/Anthropic).
- Сам отзыв или вопрос покупателя: ~150–250 символов (~100 токенов).
- Контекст карточки товара (характеристики, описание, габариты упаковки, состав, совместимость, памятка по уходу): от 6 000 символов в базовом товаре до 20 000 символов в сложных категориях (автотовары, электроника, косметика, одежда со сложной сеткой размеров). Это добавляет от 3 300 до 11 000 токенов на каждый запрос.
- Итоговый сгенерированный ответ (до 500 символов): ~150 токенов выхода.
В результате объем одного обращения составляет от 4 500 токенов при среднем описании до 12 200 токенов при тяжелом контексте.
Скрытый фактор: токенизация русского языка (BPE)
Критический технический нюанс, о котором забывают при расчете юнит-экономики, — разница алгоритмов токенизации (Byte Pair Encoding):
- Западные модели (OpenAI tiktoken, Anthropic Claude): Словарь оптимизирован под английский язык. Русский текст дробится на мелкие фрагменты: 1 токен равен всего 1.7–1.9 символов. Текст карточки в 20 000 знаков сжигает ~11 000 токенов.
- Отечественные модели (YandexGPT, GigaChat от Сбера): Имеют нативный кириллический BPE-словарь, где 1 токен вмещает 3.2–3.5 символов. Тот же самый объем текста конвертируется всего в ~6 500 токенов (почти в два раза компактнее!).
Но даже при оптимизированной токенизации отправлять 100% входящих запросов в большую модель разорительно: более трети всех обращений не требуют генерации текста и не могут быть решены нейросетью.
Архитектура фильтрации RAMSTAT: как работает двухконтурная связка «Jev AI + LLM»
Чтобы исключить лишние затраты и ликвидировать галлюцинации, в экосистеме RAMSTAT для Wildberries и Ozon реализован двухконтурный конвейер обработки обращений:
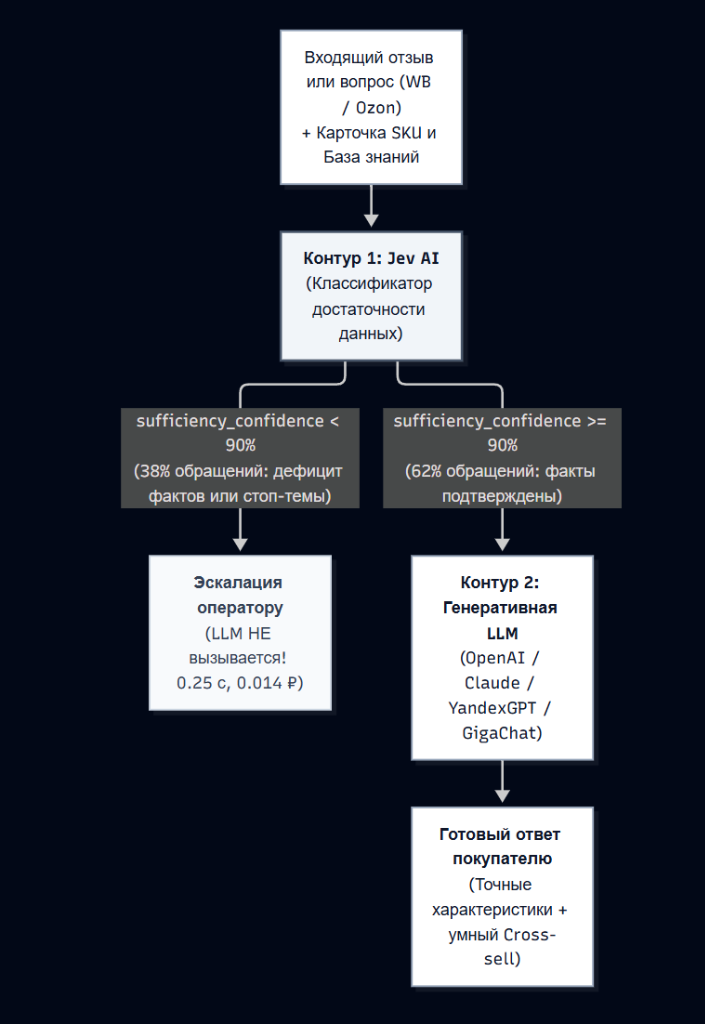
Принцип работы двухконтурной системы:
-
Контур 1 (Jev AI — классификатор достаточности данных): Специализированная легковесная модель. Она не генерирует текст ответа, а решает строгую аналитическую задачу: «Достаточно ли в переданном паспорте товара проверенной информации, чтобы однозначно ответить покупателю, и не относится ли вопрос к стоп-темам (брак, доставка со склада маркетплейса, возврат)?».
- Время проверки: 0.2 – 0.35 секунды.
- Стоимость одной проверки: $0.00015 (~0.014 ₽) — сотые доли копейки.
- Если данных недостаточно или выявлена претензия по доставке/браку, Jev AI моментально возвращает статус эскалации. Дорогая генеративная LLM вообще не запускается, а уведомление с причиной отказа сразу уходит менеджеру в Telegram.
-
Контур 2 (Генеративная LLM): Подключается только для тех 62–85% обращений, где наличие фактов в карточке на 100% подтверждено. Модель формулирует лаконичный, вежливый ответ в фирменном стиле магазина и при необходимости органично встраивает смежный артикул для допродажи.
Пороги уверенности: сколько обращений отсекается на практике
На Wildberries и Ozon обращения покупателей делятся на три неравные группы:
- Точные факты: размеры, вес, состав, температурный режим (есть в описании).
- Белые пятна: совместимость с редкими приборами, нюансы партии (в карточке нет).
- Зона маркетплейса: доставка, упаковка, брак при транспортировке, возврат денег, отмена заказа по схеме FBS.
В зависимости от выставленного порога уверенности (Confidence Threshold) меняется процент отсева:
| Порог уверенности | Доля автоответов | Доля отсева (эскалация оператору) | Поведение системы |
|---|---|---|---|
| 70% | 85% | 15% | Мягкий режим: отсекаются только явные стоп-темы и грубый дефицит информации. Риск редких неточностей. |
| 80% | 75% | 25% | Сбалансированный режим: отсекаются стоп-темы и вопросы с сомнительным контекстом. |
| 90% (Дефолт RAMSTAT) | 62% | 38% | Строгий режим максимального качества: модель отвечает только при 100% наличии подтвержденных фактов. Карточка защищена от галлюцинаций. |
Примерно 38% входящих обращений отсекаются еще до вызова генеративной модели. Это позволяет селлеру не платить за пустые генерации и защищает карточку от штрафов и блокировок за дезинформацию покупателей.
Прямые тарифы нейросетей и стоимость одного ответа
Для объективного сравнения возьмем прямые официальные тарифы API провайдеров (Direct API без наценок посредников, курс 1$ = 95 ₽):
- ChatGPT Luna 6 (OpenAI, сверхбюджетный класс): Вход $0.10 / 1M токенов, выход $0.50 / 1M токенов.
- Claude Sonnet 5.5 (Anthropic, сбалансированный класс): Вход $2.00 / 1M токенов, выход $10.00 / 1M токенов.
- GPT Astra 6 (OpenAI, тяжелый флагман): Вход $10.00 / 1M токенов, выход $50.00 / 1M токенов.
- YandexGPT Lite (Яндекс, доступный класс РФ): 0.20 ₽ за 1 000 токенов (единая ставка).
- YandexGPT Pro (Яндекс, бизнес-класс РФ): 1.20 ₽ за 1 000 токенов.
- GigaChat Lite (Сбер, доступный класс РФ): 0.20 ₽ за 1 000 токенов.
- GigaChat Pro (Сбер, бизнес-класс РФ): 1.50 ₽ за 1 000 токенов.
- GigaChat Max (Сбер, флагман рассуждений РФ): 2.50 ₽ за 1 000 токенов.
Себестоимость одного ответа при прямой генерации (без префильтра)
| Модель / Провайдер | Класс модели | Стоимость 1 ответа: средний контекст (6 000 знаков) | Стоимость 1 ответа: тяжелый контекст (20 000 знаков) | Время ответа (Latency) |
|---|---|---|---|---|
| ChatGPT Luna 6 (OpenAI) | Сверхбюджетная | 0.050 ₽ ($0.000525) | 0.123 ₽ ($0.001295) | 1.2 – 2.0 с |
| YandexGPT Lite (Яндекс) | Доступная РФ | 0.506 ₽ | 1.306 ₽ | 1.0 – 1.8 с |
| GigaChat Lite (Сбер) | Доступная РФ | 0.506 ₽ | 1.306 ₽ | 1.0 – 1.8 с |
| Claude Sonnet 5.5 (Anthropic) | Баланс интеллекта и цены | 1.000 ₽ ($0.010500) | 2.461 ₽ ($0.025900) | 2.5 – 4.0 с |
| YandexGPT Pro (Яндекс) | Продвинутая РФ | 3.036 ₽ | 7.836 ₽ | 2.5 – 4.5 с |
| GigaChat Pro (Сбер) | Продвинутая РФ | 3.795 ₽ | 9.795 ₽ | 2.5 – 4.5 с |
| GPT Astra 6 (OpenAI) | Флагман Запад | 4.988 ₽ ($0.052500) | 12.303 ₽ ($0.129500) | 5.0 – 9.0 с |
| GigaChat Max (Сбер) | Флагман РФ | 6.325 ₽ | 16.325 ₽ | 4.0 – 7.0 с |
Полный расчет экономии бюджета: 10 000 и 50 000 обращений
Посчитаем чистую экономию селлера при стандартном пороге 90% (38% отсева, 62% подтвержденных автоответов) для пула в 10 000 и 50 000 обращений на Wildberries и Ozon.
При наличии Jev AI:
- Все 10 000 вопросов проходят проверку классификатора ($1.50 = ~142.5 ₽ на весь объем).
- Только 6 200 запросов передаются в генеративную модель.
- 3 800 запросов отсекаются без расхода дорогих генеративных токенов.
Экономика на пуле 10 000 вопросов (Тяжелый контекст: 20 000 знаков)
| Модель | Затраты БЕЗ Jev AI (100% в LLM) | Затраты С Jev AI (Фильтр + 62% в LLM) | Чистая экономия (₽) | Экономия (%) |
|---|---|---|---|---|
| ChatGPT Luna 6 | 1 230 ₽ | 905 ₽ | +325 ₽ | 26.4% |
| YandexGPT Lite | 13 060 ₽ | 8 240 ₽ | +4 820 ₽ | 36.9% |
| GigaChat Lite | 13 060 ₽ | 8 240 ₽ | +4 820 ₽ | 36.9% |
| Claude Sonnet 5.5 | 24 605 ₽ | 15 398 ₽ | +9 207 ₽ | 37.4% |
| YandexGPT Pro | 78 360 ₽ | 48 726 ₽ | +29 634 ₽ | 37.8% |
| GigaChat Pro | 97 950 ₽ | 60 872 ₽ | +37 078 ₽ | 37.9% |
| GPT Astra 6 | 123 025 ₽ | 76 418 ₽ | +46 607 ₽ | 37.9% |
| GigaChat Max | 163 250 ₽ | 101 358 ₽ | +61 892 ₽ | 37.9% |
Экономика на пуле 10 000 вопросов (Средний рабочий контекст: 6 000 знаков)
- ChatGPT Luna 6: затраты снижаются с 499 ₽ до 452 ₽ (экономия +47 ₽).
- YandexGPT Lite / GigaChat Lite: экономия +1 780 ₽ (было 5 060 ₽ → стало 3 280 ₽).
- Claude Sonnet 5.5: экономия +3 648 ₽ / +$38.40 (было 9 975 ₽ → стало 6 327 ₽).
- YandexGPT Pro: экономия +11 394 ₽ (было 30 360 ₽ → стало 18 966 ₽).
- GigaChat Pro: экономия +14 278 ₽ (было 37 950 ₽ → стало 23 672 ₽).
- GPT Astra 6: экономия +18 810 ₽ / +$198.00 (было 49 875 ₽ → стало 31 065 ₽).
- GigaChat Max: экономия +23 892 ₽ (было 63 250 ₽ → стало 39 358 ₽).
Масштаб крупного мульти-маркетплейс селлера (50 000 обращений в месяц / Распродажи WB и Ozon)
Для магазинов, торгующих одновременно на Wildberries и Ozon с сотнями SKU, в периоды сезонных пиков («11.11», «Черная пятница», новогодний сезон) экономия возрастает кратно:
- На YandexGPT Lite / GigaChat Lite: чистая экономия ~24 100 ₽ в месяц.
- На Claude Sonnet 5.5: чистая экономия ~46 037 ₽ в месяц ($484).
- На YandexGPT Pro: чистая экономия ~148 170 ₽ в месяц.
- На GigaChat Pro: чистая экономия ~185 390 ₽ в месяц.
- На GPT Astra 6: чистая экономия ~233 035 ₽ в месяц ($2 453).
- На GigaChat Max: чистая экономия ~309 460 ₽ в месяц.
Подключить умную фильтрацию и автоматизировать ответы можно через ИИ-автоответчик на вопросы Wildberries и ИИ-автоответчик на вопросы Ozon в едином окне RAMSTAT: сервис по официальным API маркетплейсов отсекает 38% мусорных запросов за 0.25 с и снижает себестоимость генерации ответа до 0.05 ₽. Умная фильтрация и защита рейтинга 4.8+ работают уже на тарифе Free за 0 ₽ без привязки банковской карты — функционал ответов полностью идентичен, а подписка от 490 ₽/мес нужна лишь для того, чтобы увеличить лимит генераций под весь поток обращений.
Экономия времени: задержка ответа (Latency) и удержание рейтинга
Финансовая экономия — лишь половина эффекта. Вторая составляющая — скорость реакции, которая на Ozon напрямую влияет на сохранение статуса Premium-продавца, а на Wildberries — на удержание позиций в поиске.
1. Задержка генерации (Response Latency)
Когда покупатель задает вопрос перед оформлением заказа («Подойдет ли размер L на рост 185 см?»), он ждет ответа мгновенно. Если ответа нет в течение нескольких минут, покупатель закрывает карточку и заказывает товар конкурента.
- Без Jev AI: Модель берет нерелевантный вопрос и «думает» над тяжелым контекстом от 3.5 до 8.0 секунд, чтобы в итоге выдать отписку вроде «К сожалению, продавец не указал эту информацию». На пуле из 10 000 вопросов сервер тратит до 7.4 часов непрерывной генерации вхолостую.
- С Jev AI: Классификатор отсекает вопрос за 0.25 секунды. Покупатель не ждет пустых фраз, а запрос моментально перенаправляется живому оператору магазина.
2. Снятие лимитов API (Rate Limits: RPS / RPM)
У коммерческих шлюзов Yandex Cloud и Сбера действуют лимиты на число параллельных запросов в секунду (RPS). Во время распродаж автоответчик без префильтра может ловить ошибку HTTP 429 Too Many Requests. Срезая 38% мусорных вызовов, Jev AI снижает нагрузку на API и предотвращает сбои в пиковые часы.
3. Экономия рабочего времени службы поддержки
Менеджеру магазина больше не нужно вручную удалять неверные ответы из личных кабинетов WB и Ozon. В Telegram поступают только реальные инциденты с готовой пометкой причины эскалации, что экономит оператору 1.5–2 минуты на каждом сложном обращении.
Пошаговая инструкция: как настроить единый автоответчик для WB и Ozon за 3 шага
Настройка системы занимает не более 5 минут и выполняется без передачи паролей:
-
Шаг 1: Подключение по официальным API маркетплейсов:
- Для Wildberries: выпускается API-токен со скоупом «Вопросы и отзывы» по регламенту Open API Wildberries.
- Для Ozon: генерируется API-ключ в кабинете продавца со скоупами для работы с отзывами и чатами.
RAMSTAT не запрашивает логины и пароли, работая строго через официальные шлюзы площадок.
-
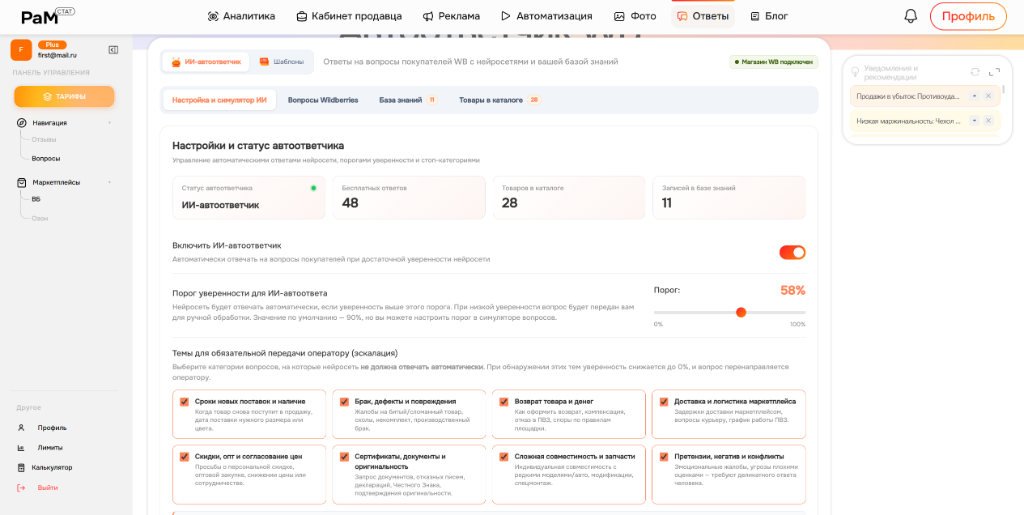
Шаг 2: Калибровка порога уверенности и стоп-тем: В разделах автоответов RAMSTAT установите порог уверенности (рекомендуется 90%) и активируйте базовые фильтры стоп-тем (брак, доставка складов FBO/FBS, претензии по упаковке Ozon Rocket или WB).
-
Шаг 3: Настройка рекомендаций и допродаж (Cross-sell): Укажите связки артикулов-компаньонов (к платью — пояс, к сковороде — лопатку). Нейросеть будет нативно встраивать рекомендацию в подтвержденные ответы, принося дополнительные повторные заказы с конверсией 7–12%.
Скрытые риски «слепых» автоответов без классификатора
Экономия на архитектуре префильтрации неизбежно приводит к скрытым кассовым потерям селлера:
- Штрафы и возвраты из-за галлюцинаций: Не имея классификатора достаточности, языковая модель стремится «угодить» покупателю и додумывает факты (например, подтверждает наличие съемного чехла или шерсти в составе, которых нет). Покупатель заказывает товар, обнаруживает несоответствие, оформляет возврат и ставит 1 звезду. Селлер оплачивает обратную логистику (за покатушки на WB и на Ozon) и теряет органические позиции карточки.
- Ответы невпопад на претензии по доставке: Когда покупатель возмущен задержкой посылки на складе маркетплейса, шаблонная отписка нейросети «Спасибо за проявленный интерес к нашему товару!» вызывает шквал негатива и гарантированный отказ от выкупа.
- Перерасход бюджета на пустых отписках: Оплата 12 000 входных токенов ради фразы «Уточните у производителя» — самая неэффективная трата маркетингового бюджета селлера.
Часто задаваемые вопросы (FAQ)
Почему двухконтурная схема (Jev AI + LLM) выгоднее единой нейросети?
Потому что задачи проверки фактов и генерации текста имеют разную вычислительную сложность. Проверить совпадение вопроса с характеристиками требует легковесной классификации за $0.00015 (0.014 ₽), тогда как генерация развернутого ответа требует развертывания тяжелой модели стоимостью до 2–16 ₽ за запрос. Использовать генеративную LLM для отсева вопросов — все равно что нанимать грузовик для доставки одного письма.
Что происходит с вопросами, которые Jev AI не пропустил в автогенерацию?
Такие вопросы не теряются и не зависают. Система моментально направляет уведомление ответственному менеджеру или в Telegram-чат магазина с текстом вопроса, ссылкой на артикул и указанием точной причины эскалации (например, отсутствие габаритов в карточке). Менеджер отвечает вручную за 30 секунд или оперативно дополняет карточку недостающими характеристиками.
💡 Резюме для селлера: Не сжигайте бюджет на наивных интеграциях LLM. Протестируйте двухконтурный ИИ-автоответчик в RAMSTAT — тариф Free доступен за 0 ₽ навсегда без привязки банковской карты. Подключите магазины Wildberries и Ozon за 5 минут и защитите рейтинг своих артикулов без переплат за лишние токены.